Imprimé ou manuscrit
« Documents anciens » recouvre deux mondes. Les imprimés (livres, journaux, annuaires, bulletins, formulaires) relèvent de l'OCR (reconnaissance optique de caractères) et se lisent d'autant mieux que la typographie est proche de la nôtre. Les manuscrits (registres paroissiaux, minutes notariales, correspondance, journaux intimes) demandent une autre technique, la reconnaissance d'écriture manuscrite (HTR), avec d'autres outils et souvent un modèle entraîné sur une main précise. Aucun logiciel d'OCR grand public ne lit les manuscrits, Searchive compris. Transkribus est l'outil de référence pour cela, en ligne et avec des crédits par page. La suite concerne l'imprimé.
Ce que l'imprimé ancien fait à l'OCR
- Jusqu'au début du XIXe siècle, le s en début et en milieu de mot ressemble à un f sans barre (le s long, ſ). Un modèle moderne peut le lire comme un f, si bien que « ſes » devient « fes ». Le texte reste lisible pour un humain mais la recherche doit en tenir compte.
- L'orthographe ancienne (« avoit », « connoître », « enfans », « tems ») n'est pas une erreur de reconnaissance : le moteur lit ce qui est imprimé. C'est votre requête qui doit prévoir les variantes.
- Les accents et la cédille (é è ê à ç œ) sont inconnus d'un modèle entraîné sur l'anglais, qui les remplace. Choisir le français comme langue du document règle l'essentiel.
- Le découpage des mots autour de l'apostrophe (« l'église », « d'Artagnan », « qu'il ») est un point où beaucoup d'indexeurs échouent.
- L'état du papier compte aussi : encre pâle, transparence du verso, rousseurs, caractères usés. La reconnaissance se dégrade progressivement et un score de confiance par page indique où.
En pratique, l'imprimé français en caractères romains, du XIXe siècle à nos jours, se lit assez bien pour être cherché. Le XVIIIe siècle se lit aussi, avec le problème du s long. Plus tôt, la typographie s'éloigne assez pour que des modèles spécialisés (OCR4all, eScriptorium avec Kraken ou les modèles d'imprimés anciens de Transkribus) donnent de meilleurs résultats.
Les outils gratuits
OCRmyPDF et Tesseract
OCRmyPDF est la voie libre et locale. Il pilote le moteur Tesseract et produit un PDF identique à l'original avec une couche de texte cherchable :
ocrmypdf --language fra --deskew --rotate-pages scan.pdf cherchable.pdfTout s'exécute sur votre ordinateur. La contrepartie est une commande par fichier en ligne de commande et rien pour chercher ensuite dans les mille PDF produits.
OCR4all et eScriptorium
Deux plateformes libres issues de la recherche en humanités numériques, conçues pour les imprimés anciens, avec des modèles spécialisés et un flux de correction et de réentraînement. Elles sont puissantes et locales mais exigent de l'installation et de l'apprentissage. Elles conviennent à une édition. Pour chercher dans ses scans elles sont lourdes.
Gallica et les bibliothèques numériques
Si le document est un imprimé publié, il est peut-être déjà numérisé et océrisé sur Gallica, sur Google Livres ou dans une bibliothèque régionale, avec la recherche en plein texte incluse. Vérifier avant de scanner soi-même fait gagner des journées. Ce qui n'y figure pas (archives privées, tirages locaux, papiers de famille) reste à traiter chez soi.
Searchive est l'application de bureau que nous avons construite pour la suite. Elle importe des dossiers entiers de scans et de photos, reconnaît chaque page en français (ou en allemand, anglais, néerlandais, italien) sur votre propre machine, puis cherche dans toute la bibliothèque avec la correspondance surlignée sur le scan. C'est gratuit pour un document et sans compte.
Liste d'attenteChercher dans des milliers de pages anciennes
Une fois la reconnaissance faite, il reste à trouver. Trois habitudes changent tout. Searchive les prend en charge ainsi.
Il faut d'abord prévoir les graphies. Un nom de famille s'écrit de trois façons dans le même carton et un lieu change d'orthographe avec le siècle. Le mode « un des mots » accepte toutes les graphies en une seule requête (Lefebvre Lefèvre Lefebure) et renvoie chaque page qui en contient une. Le mode « tous les mots » resserre la recherche (nom + lieu) et le mode « expression exacte » trouve « fils de » suivi du nom attendu. Les accents et les apostrophes fonctionnent tels que tapés : l'église trouve l'église, avec ou sans apostrophe typographique. Des tests couvrent ce comportement parce que c'est là que les indexeurs gratuits échouent.
Il faut ensuite lire l'original. Un résultat, c'est la page elle-même avec le mot surligné sur l'image du scan. La note en marge, le cachet et la mise en page de la colonne sont là. Searchive ouvre la page scannée sur la correspondance. Le texte est sélectionnable là où une couche de texte existe.
Il faut enfin savoir quoi vérifier. Chaque page garde son score de confiance. Celles qui passent sous un seuil réglable figurent dans une liste à revoir. Une page dont la première passe n'a rien extrait est retentée dans un autre mode de segmentation avant d'être considérée comme vide.
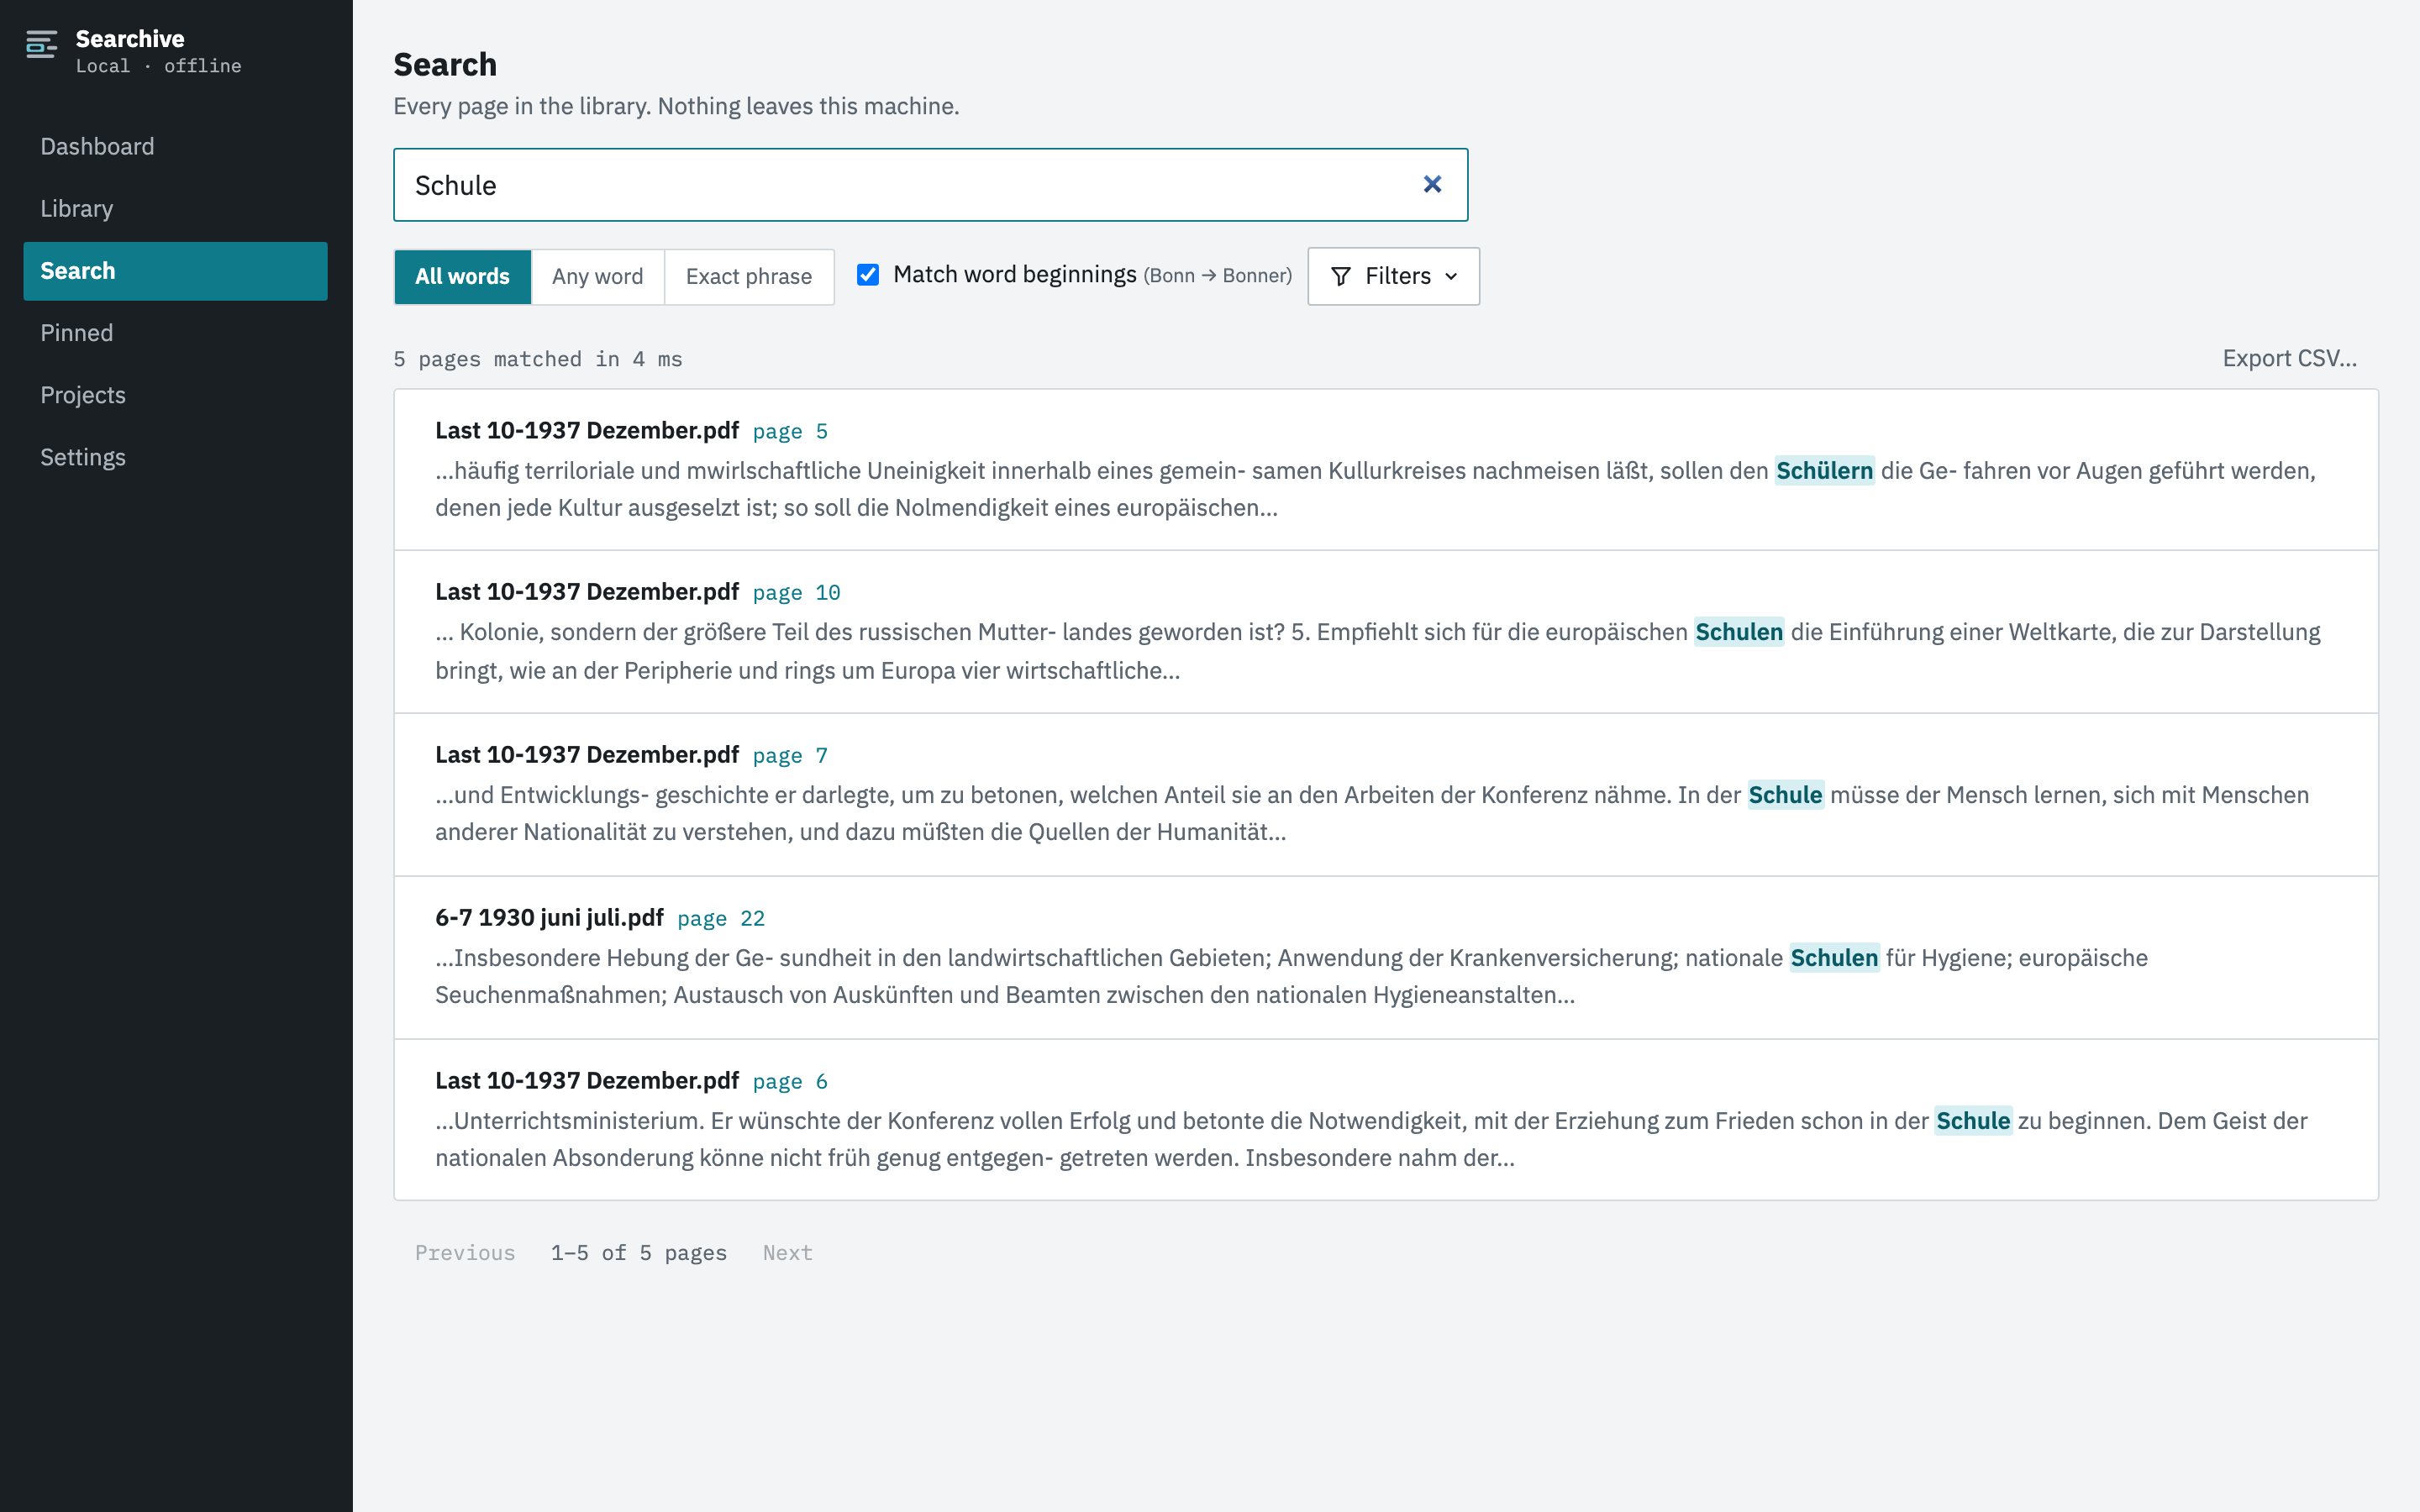
Le reste de l'outil suit le travail de recherche : on épingle une page avec une note en ses propres mots, on exporte les résultats d'une recherche en CSV pour la liste des sources et on regroupe les documents en projets sans déplacer les fichiers. Les photos prises en salle de lecture s'importent comme un seul document, avec les pages dans l'ordre de prise de vue. Tout reste dans un dossier sur votre ordinateur. Rien n'est envoyé, il n'y a pas de compte ni de statistiques d'usage. L'application fonctionne sans connexion.
Questions fréquentes
L'OCR lit-elle les manuscrits anciens ?
Non. L'OCR reconnaît l'imprimé. Les registres paroissiaux, les lettres et les actes notariés manuscrits relèvent de la reconnaissance d'écriture manuscrite (HTR), par exemple Transkribus, un service en ligne à crédits. Searchive ne lit pas l'écriture manuscrite.
Le s long (ſ) est-il reconnu ?
Le modèle français standard de Tesseract, que Searchive utilise, peut lire le s long comme un f. Un texte du XVIIIe siècle peut donc contenir des « fes » pour « ses ». La recherche en mode « un des mots » permet de taper les deux formes en une seule requête.
Comment chercher un nom écrit de plusieurs façons ?
Dans Searchive, passez en mode « un des mots » et tapez toutes les graphies connues : Lefebvre Lefèvre Lefebure. Une page correspond si elle contient l'une d'elles. Les accents et les apostrophes fonctionnent tels que vous les tapez.
Que se passe-t-il avec les pages mal reconnues ?
Chaque page reçoit un score de confiance. Les pages en dessous d'un seuil que vous choisissez apparaissent dans une liste à vérifier, au lieu de disparaître silencieusement des résultats.
Mes documents restent-ils sur mon ordinateur ?
Oui. Reconnaissance, index et recherche s'exécutent sur votre Mac ou PC Windows. Rien n'est envoyé nulle part et l'application fonctionne sans connexion.