Waarom digitaliseer je?
Kleine organisaties digitaliseren meestal om drie redenen: ruimte (de kast moet weg), veiligheid (één brand en het is weg) en terugvindbaarheid (waar is de akte van 2011 ook alweer?). De eerste twee lost een scanner op, de derde niet. Een map met 4.000 PDF's die scan0001.pdf tot scan4000.pdf heten is veiliger dan de kast en even lastig te doorzoeken. Wie er iets in zoekt, opent bestanden tot het gevonden is.
Terugvinden vraagt twee dingen die bij het scannen vaak worden overgeslagen. De tekst in de scans moet herkend zijn (OCR) en er moet een zoekfunctie zijn die over alle bestanden tegelijk werkt.
Stap 1: scannen zodat OCR het kan lezen
- Scan op 300 dpi in grijstinten of kleur. Op die resolutie wordt tekstherkenning betrouwbaar. Lager scheelt weinig in tijd en veel in fouten.
- Maak één PDF per stuk en niet per pagina. Een dossier van veertig bladzijden is één bestand. Een documentinvoer met dubbelzijdig scannen doet dit vanzelf.
- Geef bestanden namen die iets zeggen.
2011-03-14 akte levering Dorpsstraat 12.pdfis later veel waard, ook als de zoekfunctie de inhoud kent. Het jaar vooraan sorteert vanzelf. - Kies de OCR-taal bewust. Nederlandse stukken krijgen het Nederlandse model en Duitse correspondentie het Duitse. Een verkeerde taal kost precies de tekens die het Nederlands onderscheiden: ij, ë, é.
- Laat de scanner geen OCR doen als je dat later beter kunt. Veel scanners bieden een doorzoekbare PDF aan. Dat is prima als het werkt, maar de taalkeuze zit vaak verstopt en de kwaliteit wisselt. Een PDF zonder tekstlaag kun je altijd nog laten herkennen. Een slechte tekstlaag raak je moeilijker kwijt.
Stap 2: een mapstructuur is geen zoekfunctie
De klassieke aanpak is een mappenboom per jaar, per klant en per soort. Die werkt zolang je precies weet onder welke map iets ligt. Bij elke vraag die dwars door de structuur gaat schiet ze tekort: alle stukken waar deze leverancier in voorkomt, waar we die clausule eerder hebben gebruikt, welke dossiers dit perceel noemen. Daarvoor moet je de inhoud kunnen doorzoeken en niet de mapnamen.
Verkenner en Finder doorzoeken de inhoud van PDF's met een tekstlaag, maar geven alleen bestandsnamen terug, zonder pagina en zonder context. Op scans zonder tekstlaag vinden ze niets. Houd daarom een eenvoudige mappenboom (die blijft handig om in te bladeren en voor de back-up) en leg er een echte zoekfunctie overheen.
Stap 3: wel of geen documentbeheersysteem?
Een DMS (documentbeheersysteem) regelt rechten per gebruiker, workflows, versiebeheer, bewaartermijnen en koppelingen met andere software. Voor een organisatie met tientallen medewerkers en wettelijke eisen aan dossiervorming is dat de juiste keuze. Het kost een inrichtingsproject, een abonnement per gebruiker en meestal de cloud van de leverancier.
Voor een kantoor met drie mensen dat vooral wil terugvinden wat er in de kast lag, is een DMS meer dan nodig. Je wilt de scans als gewone PDF's in een gewone map, herkend, geïndexeerd en doorzoekbaar, op de computer waar ze al staan. Zonder migratie, zonder lock-in en zonder nieuwe plek waar de gegevens ook nog staan.
Searchive is voor die middenweg gemaakt. Je importeert de map, kiest per document de taal en het programma herkent en indexeert elke pagina op je eigen computer. Daarna doorzoek je het hele archief vanuit één vak, met de treffer gemarkeerd op de scan. Voor één document is het gratis en je hebt geen account nodig.
Op de wachtlijstHoe het archief er in Searchive uitziet
Je importeert door de map aan te wijzen, submappen inbegrepen. Elk bestand krijgt een controlesom, zodat een tweede import van dezelfde scan wordt opgemerkt in plaats van opnieuw verwerkt. Voor elk document dat OCR nodig heeft kies je de taal of meerdere talen. Documenten die al een tekstlaag hebben, zoals facturen uit je boekhoudpakket en brieven uit Word, worden meteen geïndexeerd. De verwerking loopt op de achtergrond met per document een status.
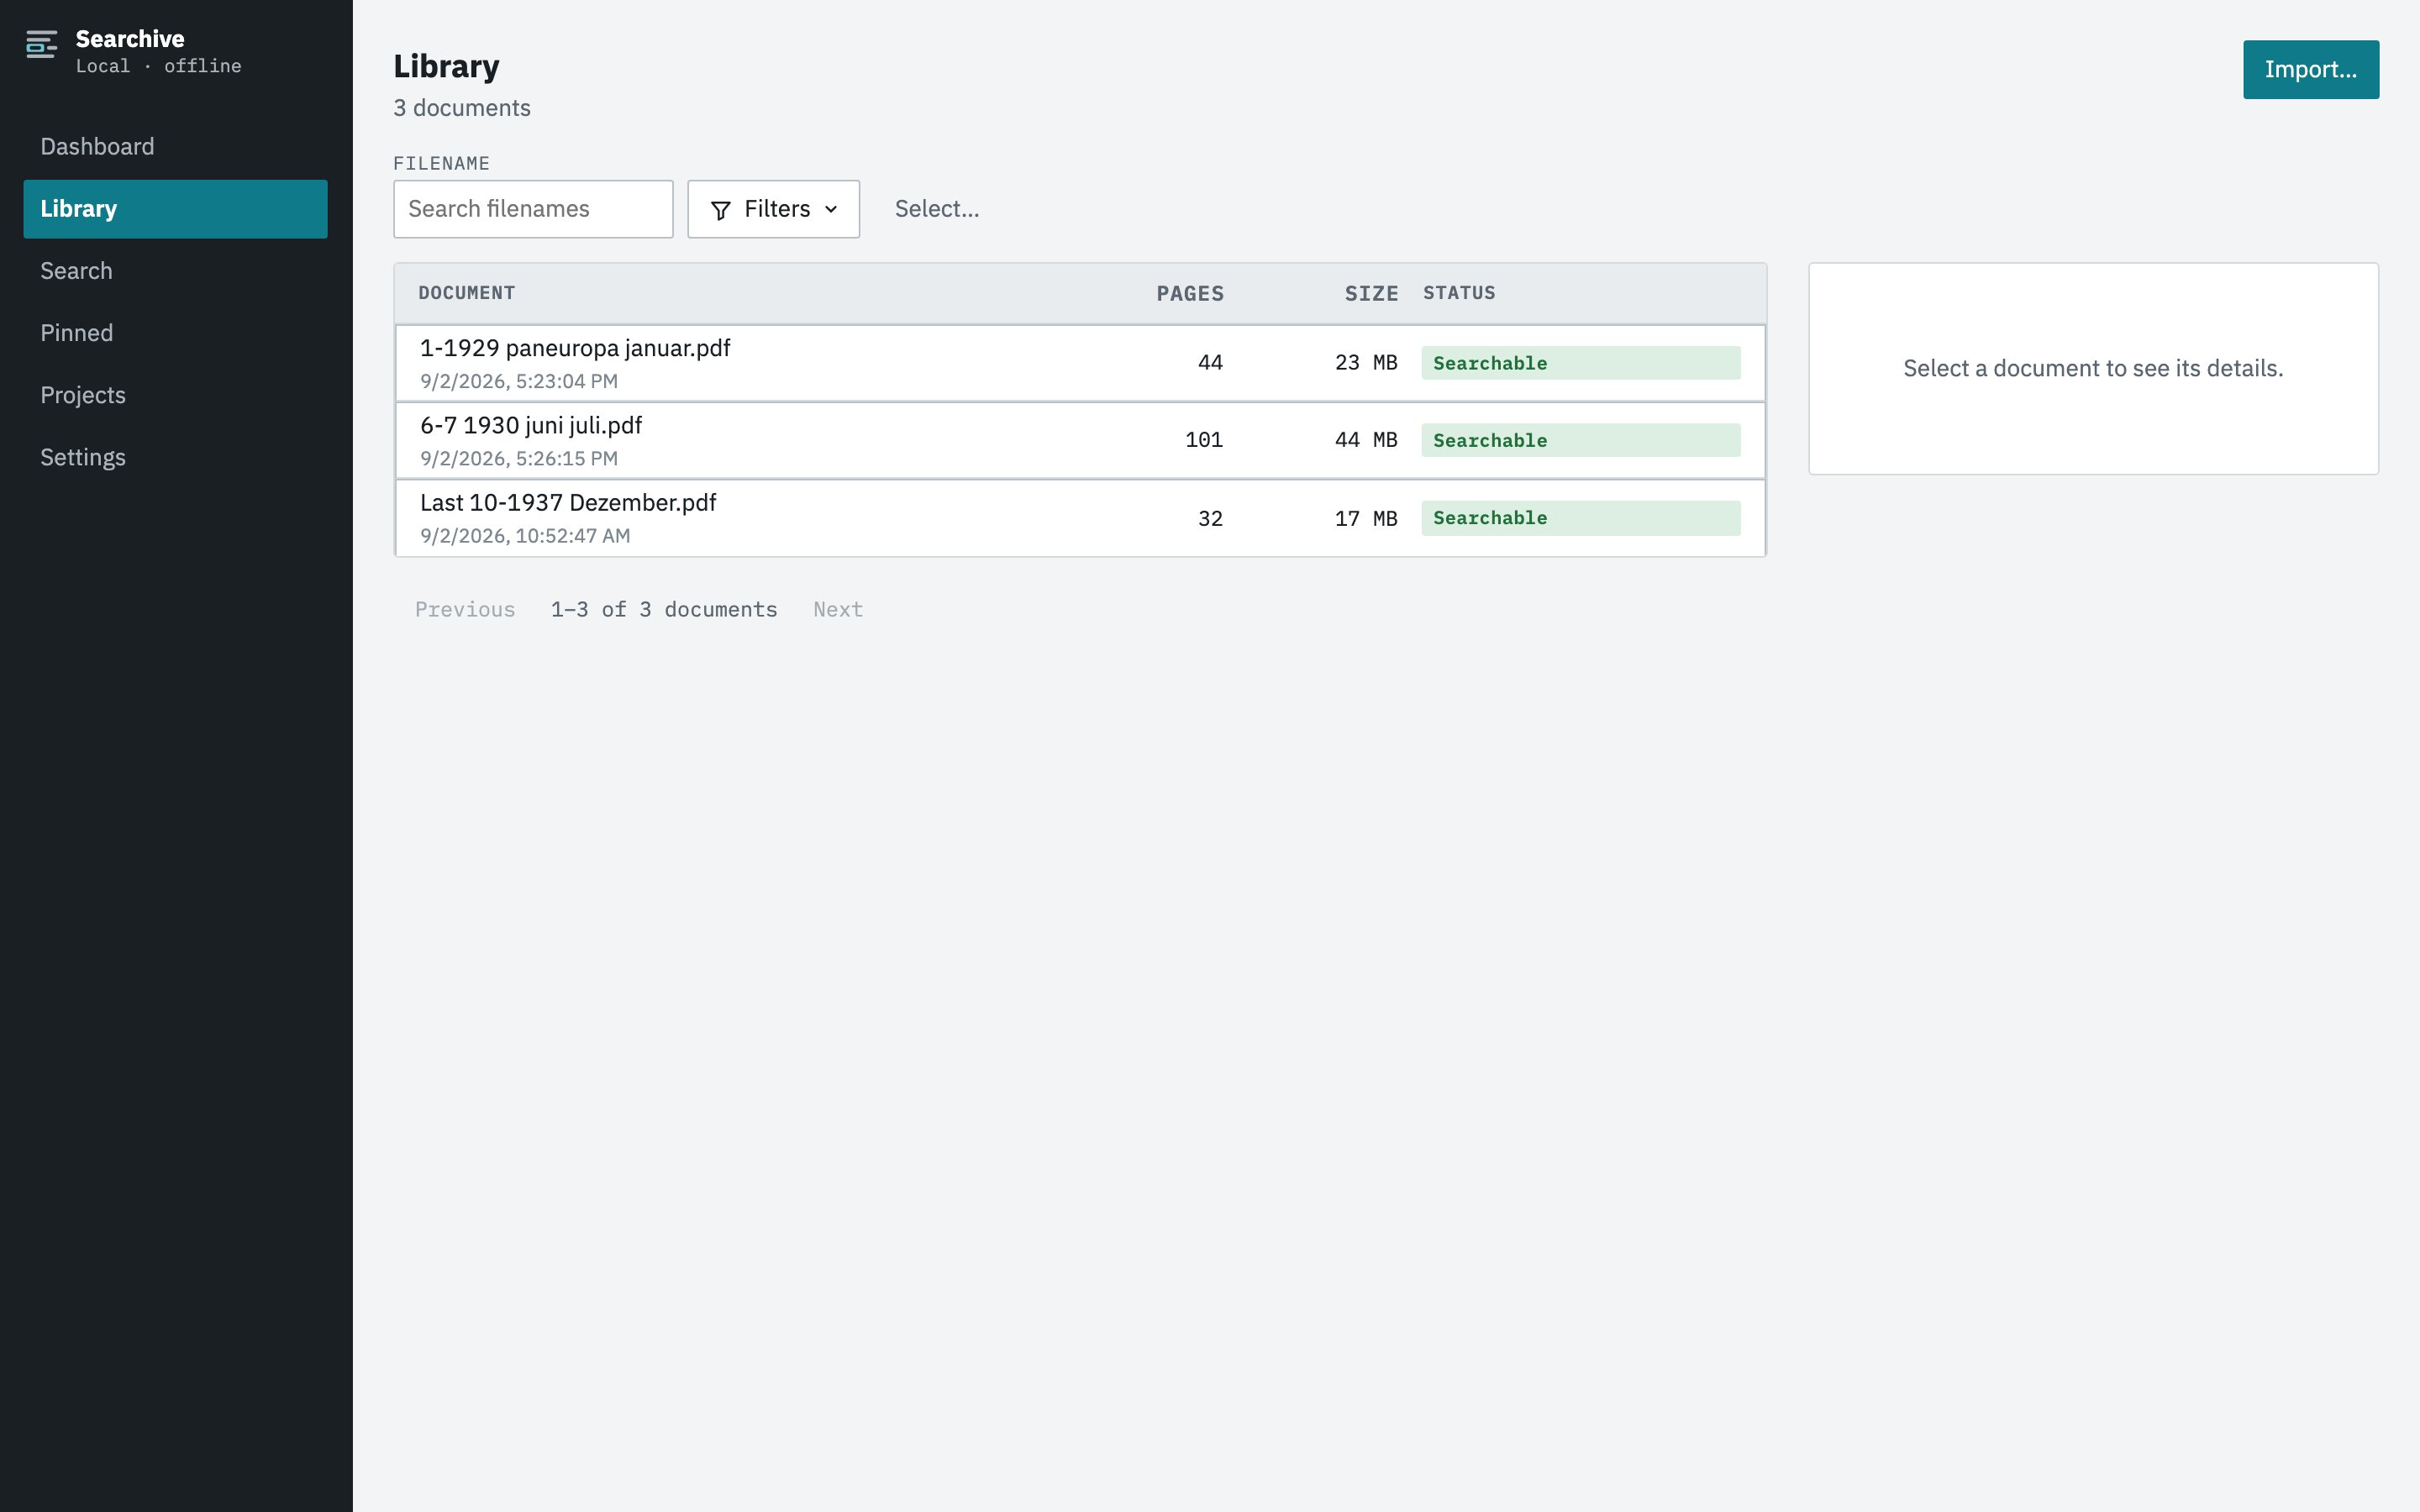
Projecten groeperen documenten zonder ze te verplaatsen: één akte kan tegelijk in "Dorpsstraat 12" en in "2011" zitten. Zoeken kan over alles of binnen een project. Je kiest tussen alle woorden, een van de woorden of een exacte zin. Resultaten tonen document, pagina en een fragment met de gevonden woorden gemarkeerd. Een klik opent de scan op die pagina met de treffer erop. Namen met apostrof of accent (l'Hôtel, D'Hondt) werken zoals je ze typt.
Pin de pagina die ertoe doet met een eigen notitie en exporteer een zoekresultaat als CSV voor een dossieroverzicht of een controle. Elke pagina houdt een betrouwbaarheidsscore van de herkenning. Een vage doorslag uit 1994 komt zo op de lijst met pagina's om na te kijken en verdwijnt niet stilletjes uit de zoekresultaten.
Alles staat in één map die je zelf kiest: originelen (nooit gewijzigd), doorzoekbare kopieën en de index. Die map zit in je gewone back-up. Er is geen server, geen account en niets verlaat het kantoor. Je betaalt één keer, dus er verloopt niets. Na de proefperiode van 14 dagen houdt de gratis versie één document volledig werkend en blijft de rest van je bibliotheek leesbaar, doorzoekbaar en exporteerbaar.
Wat het niet doet
Searchive is geen DMS. Er zijn geen gebruikersrechten, workflows of bewaartermijnen en meerdere mensen kunnen niet tegelijk in één bibliotheek werken. Handschrift wordt niet herkend. Het leest Nederlands, Duits, Frans, Engels en Italiaans en andere talen nog niet. Wie een van die dingen nodig heeft, moet naar een ander soort product kijken. Dat zeggen we liever hier dan na de aankoop.
Veelgestelde vragen
Welke scanresolutie moet ik gebruiken?
300 dpi in grijstinten of kleur is de veilige keuze voor tekstherkenning. Lager scant sneller, maar kleine letters en accenten worden dan onbetrouwbaar. Hoger geeft grotere bestanden zonder betere herkenning van normaal drukwerk.
Heb ik een documentbeheersysteem nodig?
Voor het terugvinden van stukken in een gescand archief niet. Een DMS regelt rechten, workflows, versies en bewaartermijnen. Wie alleen wil kunnen zoeken in wat is gescand heeft genoeg aan een map met PDF's en een zoekprogramma. Alles blijft gewone bestanden.
Mag ik het papier weggooien na het scannen?
Dat is een vraag voor je accountant of jurist en niet voor een softwarepagina. Voor sommige stukken volstaat een digitale kopie en voor andere niet. Wat wij wel kunnen zeggen: bewaar de scan als PDF, laat het origineel ongewijzigd en houd de bestanden in een map die in je back-up zit.
Kunnen meerdere collega's in dezelfde bibliotheek zoeken?
Searchive is een desktopprogramma per computer. De bibliotheek is één map die je naar een andere computer kunt kopiëren. Een gedeelde server of gelijktijdig werken op één bibliotheek is er niet.
Leest het ook handgeschreven stukken?
Nee. Tekstherkenning werkt op gedrukte en getypte tekst. Handgeschreven notulen of brieven kun je wel opnemen en bekijken maar niet op tekst doorzoeken.